
二分查找/排序
1、二分查找-I
1.1、问题描述
请实现无重复数字的升序数组的二分查找
给定一个 元素升序的、无重复数字的整型数组 nums 和一个目标值 target ,写一个函数搜索 nums 中的 target,如果目标值存在返回下标(下标从 0 开始),否则返回 -1。
示例1
输入:[-1,0,3,4,6,10,13,14],13
返回值:6
说明:13 出现在nums中并且下标为 6
示例2
输入:[],3
返回值:-1
说明:nums为空,返回-1
示例3
输入:[-1,0,3,4,6,10,13,14],2
返回值:-1
说明:2 不存在nums中因此返回 -1
1.2、思路及代码
思路:
- 定义一个
left变量来表示搜索范围的左边界,初始值为0,表示数组的开始位置。 - 定义一个
right变量来表示搜索范围的右边界,初始值为数组的最后一个位置。 - 使用一个
while循环来进行二分查找,循环条件是left小于等于right。 - 在每一次循环中,计算中间位置
mid,即(left + right) / 2。 - 检查中间位置的元素
nums[mid]与目标值target的大小关系:- 如果
nums[mid]等于target,表示找到了目标值,返回mid作为结果。 - 如果
nums[mid]小于target,表示目标值在右半部分,更新left为mid + 1。 - 如果
nums[mid]大于target,表示目标值在左半部分,更新right为mid - 1。
- 如果
- 重复以上步骤,直到
left大于right,表示搜索范围为空,未找到目标值,返回 -1。
参考代码:
#include <iostream>
#include <vector>

using namespace std;

int binarySearch(vector<int>& nums, int target) {
    int left = 0; // 左边界
    int right = nums.size() - 1; // 右边界

    while (left <= right) {
        int mid = left + (right - left) / 2; // 计算中间位置

        if (nums[mid] == target) {
            return mid; // 如果找到目标值,返回下标
        } else if (nums[mid] < target) {
            left = mid + 1; // 如果中间值小于目标值,缩小搜索范围到右半部分
        } else {
            right = mid - 1; // 如果中间值大于目标值,缩小搜索范围到左半部分
        }
    }

    return -1; // 如果未找到目标值,返回-1
}

int main() {
    vector<int> nums = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10}; // 示例升序数组
    int target = 6; // 目标值
    int result = binarySearch(nums, target); // 调用二分查找函数

    if (result != -1) {
        cout << "目标值 " << target << " 的下标为: " << result << endl;
    } else {
        cout << "目标值 " << target << " 未找到" << endl;
    }

    return 0;
}
时间复杂度是 O(log n),其中 n 是数组的长度。
2、二维数组中的查找
2.1、问题描述
在一个二维数组array中(每个一维数组的长度相同),每一行都按照从左到右递增的顺序排序,每一列都按照从上到下递增的顺序排序。请完成一个函数,输入这样的一个二维数组和一个整数,判断数组中是否含有该整数。
[
[1,2,8,9],
[2,4,9,12],
[4,7,10,13],
[6,8,11,15]
]
给定 target = 7,返回 true。
给定 target = 3,返回 false。
示例1
输入:7,[[1,2,8,9],[2,4,9,12],[4,7,10,13],[6,8,11,15]]
返回值:true
说明:存在7,返回true
示例2
输入:1,[[2]]
返回值:false
示例3
输入:3,[[1,2,8,9],[2,4,9,12],[4,7,10,13],[6,8,11,15]]
返回值:false
说明:不存在3,返回false
2.2、思路及代码
思路:
- 首先,检查数组是否为空,如果为空则直接返回false。
- 获取二维数组的行数和列数,以及初始化行指针
row为0(从第一行开始),列指针col为最后一列(从最后一列开始)。 - 在一个
while循环中,不断比较当前元素matrix[row][col]与目标值target:- 如果当前元素等于目标值,表示找到目标值,返回true。
- 如果当前元素小于目标值,说明目标值可能在当前行的右侧,排除当前行,将行指针
row增加1。 - 如果当前元素大于目标值,说明目标值可能在当前列的上方,排除当前列,将列指针
col减少1。
- 重复以上步骤直到
row超出数组的行数或col小于0,此时说明遍历完整个数组未找到目标值,返回false。
参考代码:
#include <iostream>
#include <vector>

using namespace std;

bool findInMatrix(vector<vector<int>>& matrix, int target) {
    if (matrix.empty() || matrix[0].empty()) {
        return false; // 空数组,直接返回false
    }

    int rows = matrix.size(); // 获取二维数组的行数
    int cols = matrix[0].size(); // 获取二维数组的列数

    int row = 0; // 从第一行开始
    int col = cols - 1; // 从最后一列开始

    while (row < rows && col >= 0) {
        int current = matrix[row][col]; // 当前元素

        if (current == target) {
            return true; // 找到目标值,返回true
        } else if (current < target) {
            row++; // 如果当前元素小于目标值,排除当前行
        } else {
            col--; // 如果当前元素大于目标值,排除当前列
        }
    }

    return false; // 遍历完整个数组未找到目标值,返回false
}

int main() {
    vector<vector<int>> matrix = {
        {1, 2, 8, 9},
        {2, 4, 9, 12},
        {4, 7, 10, 13},
        {6, 8, 11, 15}
    };

    int target = 0;
    cin >> target;

    bool result = findInMatrix(matrix, target);

    if (result) {
        cout << "目标值 " << target << " 存在于数组中" << endl;
    }
    else {
        cout << "目标值 " << target << " 不存在于数组中" << endl;
    }

    return 0;
}
时间复杂度是 O(rows + cols),其中 rows 和 cols 分别是数组的行数和列数,因为在最坏情况下需要遍历整个数组。
3、寻找峰值
3.1、问题描述
给定一个长度为n的数组nums,请你找到峰值并返回其索引。数组可能包含多个峰值,在这种情况下,返回任何一个所在位置即可。
1.峰值元素是指其值严格大于左右相邻值的元素。严格大于即不能有等于
2.假设 nums[-1] = nums[n] = −∞−∞
3.对于所有有效的 i 都有 nums[i] != nums[i + 1]
4.你可以使用O(logN)的时间复杂度实现此问题吗?
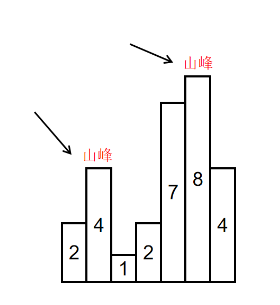
如输入[2,4,1,2,7,8,4]时,会形成两个山峰,一个是索引为1,峰值为4的山峰,另一个是索引为5,峰值为8的山峰,如下图所示:
示例1
输入:[2,4,1,2,7,8,4]
返回值:1
说明:4和8都是峰值元素,返回4的索引1或者8的索引5都可以
示例2
输入:[1,2,3,1]
返回值:2
说明:3 是峰值元素,返回其索引 2
3.2、思路及代码
思路:
- 初始化左指针
left为0,右指针right为数组最后一个元素的索引。 - 在一个
while循环中,不断将区间缩小至只包含一个元素,即left与right相等。每次循环,计算中间元素的索引mid。 - 检查中间元素
nums[mid]与其右侧相邻元素nums[mid + 1]的大小关系:- 如果
nums[mid]严格小于nums[mid + 1],则峰值位于右半部分,更新左指针left为mid + 1。 - 否则,峰值位于左半部分,更新右指针
right为mid。
- 如果
- 循环继续,不断缩小区间,直到
left与right相等,此时指向的元素就是峰值。 - 返回
left即可,它指向了峰值的索引。
参考代码:
#include <vector>

using namespace std;

int findPeakElement(vector<int>& nums) {
    int left = 0; // 左指针
    int right = nums.size() - 1; // 右指针

    while (left < right) {
        int mid = left + (right - left) / 2; // 计算中间元素的索引

        // 如果中间元素严格小于右侧元素,则峰值位于右半部分
        if (nums[mid] < nums[mid + 1]) {
            left = mid + 1;
        } else {
            right = mid;
        }
    }

    return left; // 返回峰值的索引
}

int main() {
    vector<int> nums = {1, 2, 8, 9, 5, 4, 3};

    int peakIndex = findPeakElement(nums);

    cout << "The peak element is at index: " << peakIndex << endl;

    return 0;
}
时间复杂度是 O(logN),因为每次迭代都将搜索区间减半,直到找到峰值。
4、数组中的逆序对
4.1、问题描述
在数组中的两个数字,如果前面一个数字大于后面的数字,则这两个数字组成一个逆序对。输入一个数组,求出这个数组中的逆序对的总数P。并将P对1000000007取模的结果输出。 即输出P mod 1000000007。
示例1
输入:[1,2,3,4,5,6,7,0]
返回值:7
示例2
输入:[1,2,3]
返回值:0
4.2、思路及代码
思路:
InversePairs函数是主函数,它接受一个整数数组data,并在归并排序的过程中记录逆序对的数量。MergeSort函数是归并排序的核心部分,它接受起始和结束索引start和end,并将数组data划分成两个部分进行归并排序。递归的结束条件是start == end,此时返回0。- 在
MergeSort函数中,首先计算左半部分和右半部分的逆序对数量left和right,然后计算跨越两个半部分的逆序对数量count。 - 使用归并排序的方法合并左半部分和右半部分,同时统计跨越两半部分的逆序对数量。
- 返回总的逆序对数量,取模 1000000007,以防止整数溢出。
参考代码:
#include <iostream>
#include <vector>

using namespace std;

class Solution {
public:
    int InversePairs(vector<int>& data) {
        if (data.empty()) {
            return 0;
        }

        vector<int> copy(data.size());
        return MergeSort(data, copy, 0, data.size() - 1) % 1000000007;
    }

    int MergeSort(vector<int>& data, vector<int>& copy, int start, int end) {
        if (start == end) {
            copy[start] = data[start];
            return 0;
        }

        int length = (end - start) / 2;
        int left = MergeSort(data, copy, start, start + length) % 1000000007;
        int right = MergeSort(data, copy, start + length + 1, end) % 1000000007;

        int i = start + length;
        int j = end;
        int indexCopy = end;
        int count = 0;

        while (i >= start && j >= start + length + 1) {
            if (data[i] > data[j]) {
                copy[indexCopy--] = data[i--];
                count += j - start - length;
                count %= 1000000007;
            } else {
                copy[indexCopy--] = data[j--];
            }
        }

        for (; i >= start; i--) {
            copy[indexCopy--] = data[i];
        }

        for (; j >= start + length + 1; j--) {
            copy[indexCopy--] = data[j];
        }

        for (int k = start; k <= end; k++) {
            data[k] = copy[k];
        }

        return (left + right + count) % 1000000007;
    }
};

int main() {
    Solution solution;
    vector<int> data = {7, 5, 6, 4};
    int result = solution.InversePairs(data);
    cout << "The number of inverse pairs is: " << result << endl;

    return 0;
}
时间复杂度为 O(nlogn),其中 n 是数组的长度。因为要进行归并排序,所以在大规模数据的情况下也能高效解决问题。
5、旋转数组的最小数字
5.1、问题描述
有一个长度为 n 的非降序数组,比如[1,2,3,4,5],将它进行旋转,即把一个数组最开始的若干个元素搬到数组的末尾,变成一个旋转数组,比如变成了[3,4,5,1,2],或者[4,5,1,2,3]这样的。请问,给定这样一个旋转数组,求数组中的最小值。
示例1
输入:[3,4,5,1,2]
返回值:1
示例2
输入:[3,100,200,3]
返回值:3
5.1、思路及代码
思路:
- 初始化两个指针,
left和right,分别指向数组的开头和末尾。 - 在每一步的迭代中,首先计算中间元素的索引
mid,通过mid = left + (right - left) / 2计算。 - 比较
nums[mid]和nums[right],如果nums[mid]小于nums[right],说明最小值在mid的左侧,将right更新为mid;否则,最小值在mid的右侧,将left更新为mid + 1。 - 不断迭代上述步骤,直到
left不小于right,此时left指向的元素就是最小值。
参考代码:
#include <iostream>
#include <vector>

using namespace std;

class Solution {
public:
    int findMin(vector<int>& nums) {
        int left = 0;
        int right = nums.size() - 1;

        while (left < right) {
            int mid = left + (right - left) / 2;

            if (nums[mid] < nums[right]) {
                right = mid;
            } else if (nums[mid] > nums[right]) {
                left = mid + 1;
            } else {
                right--;
            }
        }

        return nums[left];
    }
};

int main() {
    Solution solution;
    vector<int> nums = {3, 4, 5, 1, 2};
    int min_value = solution.findMin(nums);
    cout << "The minimum value in the rotated array is: " << min_value << endl;

    return 0;
}
核心思想是利用二分查找来减小搜索空间,根据中间元素和右边界元素的大小关系,确定最小值在左侧还是右侧。这样可以将时间复杂度降低到 O(log n),其中 n 是数组的长度,是一种高效的解决方法。
6、比较版本号
6.1、问题描述
牛客项目发布项目版本时会有版本号,比如1.02.11,2.14.4等等
现在给你2个版本号version1和version2,请你比较他们的大小
版本号是由修订号组成,修订号与修订号之间由一个"."连接。1个修订号可能有多位数字组成,修订号可能包含前导0,且是合法的。例如,1.02.11,0.1,0.2都是合法的版本号
每个版本号至少包含1个修订号。
修订号从左到右编号,下标从0开始,最左边的修订号下标为0,下一个修订号下标为1,以此类推。
比较规则:
一. 比较版本号时,请按从左到右的顺序依次比较它们的修订号。比较修订号时,只需比较忽略任何前导零后的整数值。比如"0.1"和"0.01"的版本号是相等的
二. 如果版本号没有指定某个下标处的修订号,则该修订号视为0。例如,"1.1"的版本号小于"1.1.1"。因为"1.1"的版本号相当于"1.1.0",第3位修订号的下标为0,小于1
三. version1 > version2 返回1,如果 version1 < version2 返回-1,不然返回0.
示例1
输入:"1.1","2.1"
返回值:-1
说明:
version1 中下标为 0 的修订号是 "1",version2 中下标为 0 的修订号是 "2" 。1 < 2,所以 version1 < version2,返回-1
示例2
输入:"1.1","1.01"
返回值:0
说明:
version2忽略前导0,为"1.1",和version相同,返回0
示例3
输入:"1.1","1.1.1"
返回值:-1
说明:
"1.1"的版本号小于"1.1.1"。因为"1.1"的版本号相当于"1.1.0",第3位修订号的下标为0,小于1,所以version1 < version2,返回-1
示例4
输入:"2.0.1","2"
返回值:1
说明:
version1的下标2>version2的下标2,返回1
示例5
输入:"0.226","0.36"
返回值:1
说明:
226>36,version1的下标2>version2的下标2,返回1
6.2、思路及代码
思路:
parseVersion方法将版本号字符串分割为整数数组。- 在
compareVersion方法中,使用parseVersion方法将两个版本号字符串分别解析为整数数组。 - 通过比较两个整数数组的元素,按照题目规则确定版本号的大小。
参考代码:
#include <iostream>
#include <vector>
#include <sstream>

using namespace std;

class Solution {
public:
    int compareVersion(string version1, string version2) {
        // 将版本号字符串转换为整数数组
        vector<int> v1 = parseVersion(version1);
        vector<int> v2 = parseVersion(version2);

        // 比较版本号数组的大小
        int n1 = v1.size();
        int n2 = v2.size();
        int n = max(n1, n2);
        for (int i = 0; i < n; i++) {
            int num1 = (i < n1) ? v1[i] : 0;
            int num2 = (i < n2) ? v2[i] : 0;
            if (num1 < num2) return -1;
            if (num1 > num2) return 1;
        }

        return 0;
    }

    vector<int> parseVersion(string version) {
        vector<int> result;
        istringstream ss(version);
        string token;

        while (getline(ss, token, '.')) {
            result.push_back(stoi(token));
        }

        return result;
    }
};

int main() {
    Solution solution;
    string version1, version2;

    cout << "Enter version1: ";
    cin >> version1;
    cout << "Enter version2: ";
    cin >> version2;

    int result = solution.compareVersion(version1, version2);

    if (result == -1) {
        cout << "version1 is smaller than version2" << endl;
    } else if (result == 1) {
        cout << "version1 is larger than version2" << endl;
    } else {
        cout << "version1 is equal to version2" << endl;
    }

    return 0;
}