
TCP/UDP详解
1、TCP主要特点
- 面向连接:
- TCP连接只能有两个端点,TCP连接是一对一的。
- TCP提供可靠连接服务。
- TCP提供全双工通信。
- 面向字节流:
- TCP和应用程序交互是一次一个数据块进行交互。但是TCP会把应用程序交下来的数据块看成一串无结构的字节流。
- TCP报文收发之间的数据块不一定相同(因为我不一定一次接受多少受网络情况,拥塞情况控制)但是字节流一定相同。
- TCP根据对方的接收能力和网络拥塞情况将字节流分成大小不同的段发送给接收缓存。

- TCP的连接套接字连接两端的插口包含IP和端口号。全双工抽象连接。
2、TCP的报文格式
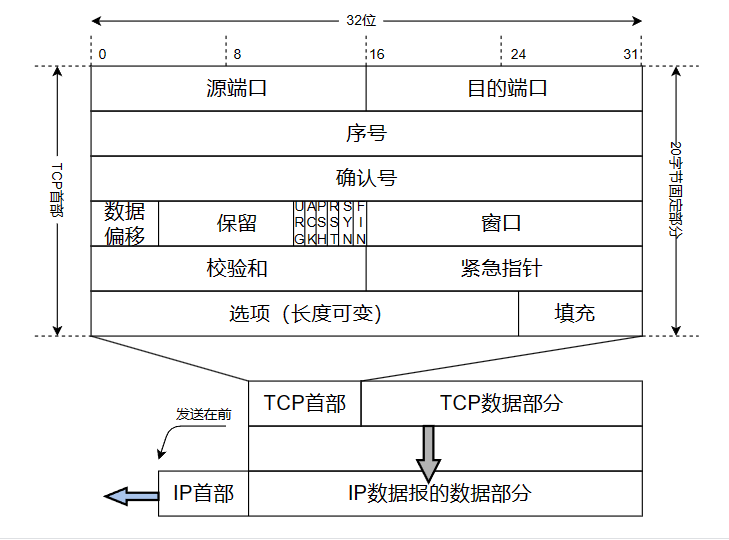
- 源端口,目的端口各占两个字节是运输层与应用层交互的接口。
- 序号(4B):seq,字节序号本报文段所携带数据的第一个字节的序号。
- 确认号(4B):ack,期望对方下次发来数据的第一个字节的序号。
- 数据偏移(4bit):标志着报文段数据部分起始位置距离报文段起始位置的距离即首部长度。
- URG(1B),紧急位置1,立刻将TCP发送缓存中的字节流打包成报文发送出去。
- ACK(1B),ACK = 1代表确认号有效。
- PSH(1B),PSH = 1,接收方立刻将接收缓存数据上交给应用进程。
- RST(1B),RST = 1,TCP连接中出现严重差错必须释放连接然后在重新建立运输连接。
- SYN(1B),SYN = 1,表示这是一个连接请求或连接接受的报文。
- FIN(1B),FIN = 1,用来释放一个连接。FIN为1表明报文段发送端已发送完成,并要求释放连接。
- 窗口(2B),告诉对方从确认号开始接收方目前允许对方发送的数据量。
- 检验和(2B),类似于UDP首部和数据这两部分计算时要在TCP报文段之前加上伪首部。
- 紧急指针,16位,当URG = 1时,这部分记录了紧急数据的大小把它放在数据部分的最前面发出去。
- 选项字段:长度可变最大报文段数据部分长度MSS,MSS告诉对方TCP我缓存最大能接受的长度为MSS。
MSS太大IP层分片只要有一片出错就得重传。
MSS太小效率低下。
- 其它选项:
窗口扩大选项:占3字节,其中一个字节S为窗口扩大的位数,比如(16+S)但是最大值不能超过30位
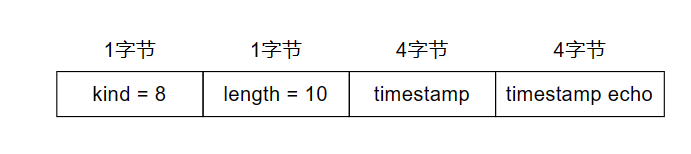
时间戳选项:
1.计算往返时延。
发送时打一个时间戳放在timestamp中,收到确认报文后再打一个时间戳此时将之前的timestamp中的时间放在timestamp echo中然后将收到确认报文的时间戳放在timestamp中二者相减可以得到RTT。
2.防止序号回绕。
由于序号编码空间是32位的所以一共是2的32次方。对于高带宽的网络很容易消耗完,也就是说接收方可能会收到两次相同序号的报文,如果不加标记,接收方会认为这两个报文是相同的然后就会丢弃。时间戳选项会将两个报文标记好时间戳这样接收方就不会丢弃了。
- 填充。
为了保证TCP首部是4字节的整数倍。
3、TCP的可靠传输
3.1、TCP连接的两个端点都有两个窗口:
发送窗口:准备发送的数据和已发送但未收到确认的数据。
接收窗口:按序接收但没有上交的数据,不按序接收的数据。

- P3 - P1 = A的发送窗口(又称为通知窗口)
- P2 - P1 = 已发送但尚未收到确认的字节数
- P3 - P2 = 允许发送但尚未发送的字节数(又称为可用窗口)
如图所示发送窗口按序发送窗口中的字节流,如果发送且收到确认则滑出窗口如果已发送但未收到确认则留在发送窗口中用来准备重传。
接收窗口将按序接收字节流如果收到的字节流无序则仍然会留在接收窗口中。比如我先收到了37则37不会被确认交付主机因为前面的34-36还没有被接收当前面的34-36被接收后34-37才会一起被交付主机。
注意事项:
- TCP发送窗口是由对方发回的报文段(窗口大小,ack)设置的但是同一时刻发送窗口接收窗口大小未必相等(当接收方发回一个报文窗口大小改变但由于网络时延发送方窗口值可能不变)。
- 接收方应该有累计确认功能这样可以减小传输开销。
- TCP是全双工通信,所以两端都有发送窗口和接收窗口。
3.2、发送缓冲区和接收缓冲区
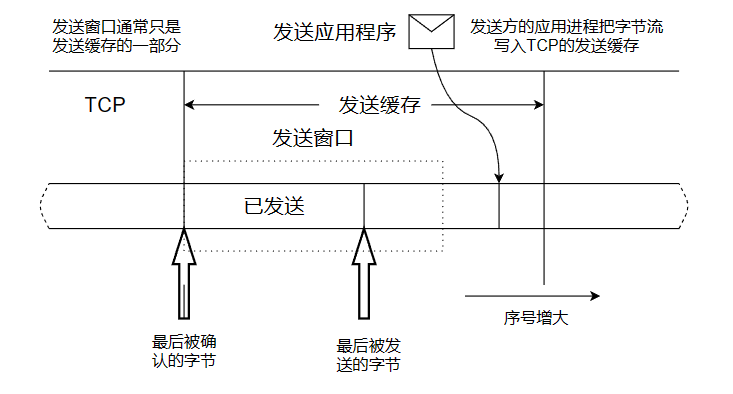
发送窗口只是发送缓冲区的一部分,发送缓冲区通常包括发送方应用程序传送给发送方TCP准备发送的数据。这里面包括已发送但还未收到确认的数据和未发送但在发送窗口的数据以及未发送但不再发送窗口的数据。
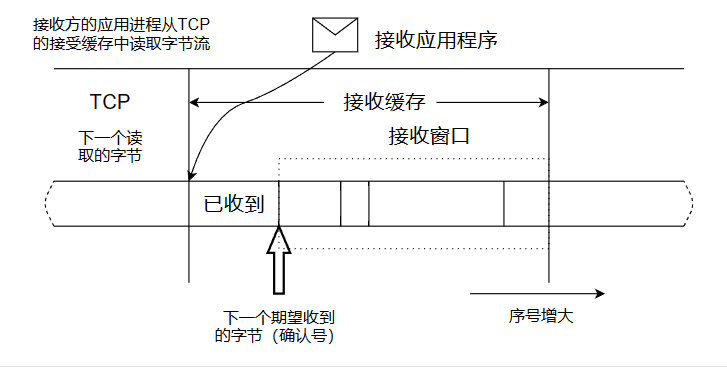
接收缓冲区包含了按序到达但尚未被应用程序读取的数据,不按序到达以及尚未进入接收窗口的数据。
4、TCP的流量控制
4.1、流量控制介绍
发送方一次发送的字节数量不要太多要让对方来的及接收。接收方是通过调整滑动窗口来进行流量控制的。
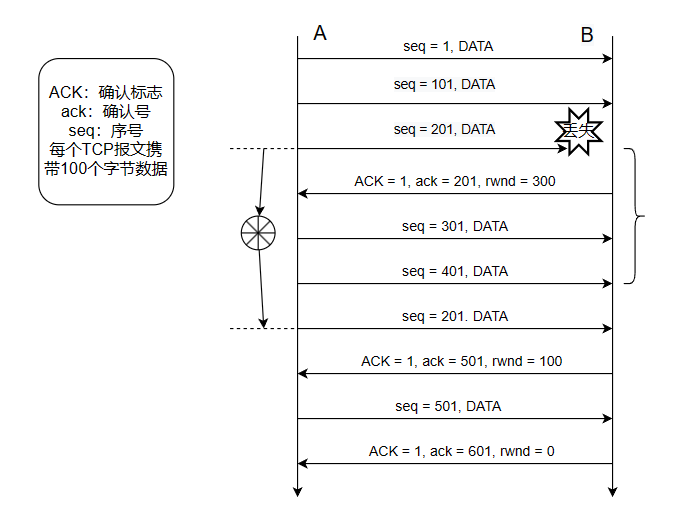
- 来看下面这样一个实例A为发送方,B为接收方。B的接收窗口由400字节。
- 首先A向B发送了一个序号为1的100字节的数据(1~100)。此时B的接收窗口还剩300字节。
- 然后A向B发送了序号为101的100字节数据(101~200).此时B的接收窗口还剩200字节。
- 然后A向B发送了序号为201的100字节的数据(201~300)但是这个报文丢失了。
- 此时B向A发送一个回复报文ACK = 201说明我已经接收1~200字节的数据下一次要从201开始发。同时进行了一次流量控制即rwnd = 300也就是说B能接收300字节。所以A要发送201~500的报文。
- A已经发送过201的报文了所以它连续发送301,401的报文此时他知道201发送失败进行超时重传。
- 这时A收到了B成功收到401的报文下一次要从501开始发而且又进行了一次流量控制rwnd = 100还能接收100字节的数据。
- 然后A又继续发送了一个序号为501的报文,然后A停止发送。然后收到了B返回的回复序号为601滑动窗口置为0的报文。
4.2、死锁问题及解决
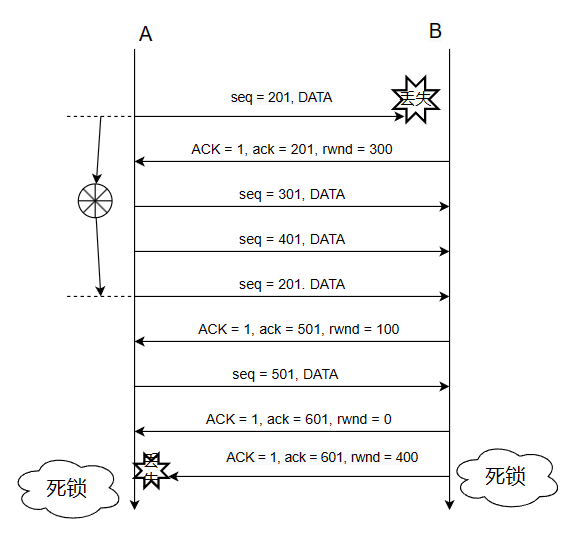
接上文,过了一段时间后B的接收缓存又有了一些存储空间。这时候会向A发送一个报文下次发送的序号为601,rwnd=400滑动窗口。但是如果这个报文丢失那么就会造成A不知道B中滑动窗口更新的消息那么就永远不会向B发送报文。
解决方案:TCP为每个连接都设置了一个持续计时器。只要收到对方的零窗口通知,就启动该持续计时器:
持续计时器到期发送一个零窗口探测报文段,对方再确认这个探测报文段时给出现在的窗口值如果窗口值仍然是0,接收方确认报文方重新设置持续计数器;若窗口不是0,死锁的僵局便被打破了。
5、TCP的效率问题
5.1、TCP的3种发送时机
- 当发送缓存中达到双方约定的MSS时然后发送。
- 当URG = 1时立刻发送。
- 当发送方一个计时器期限到了就把当前已有的数据装入报文段发送出去(这个数据长度不能超过MSS)
5.2、TCP的效率问题
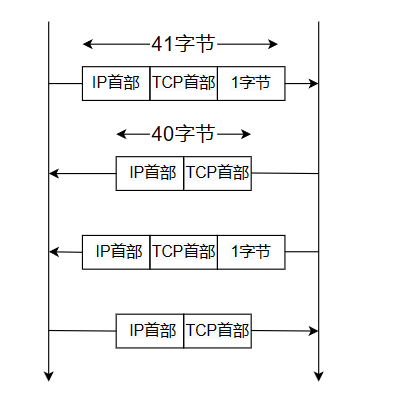
举例:
比如说Telnet远程终端协议客户端A向服务端B发送一个字符需要消耗41字节,B端服务器向A发送一个确认报文40字节,同时服务端要向客户端回显那一个字符。又是41字节,A客户端向B服务端发送一个确认报文40个字节我一共要交流2字节的数据我却用了162字节的报文利用率太低了。
解决方案:Nagle算法
发送方发送第一个字节,然后缓存剩下的数据字节。发送方收到对方发送的确认报文以后才把发送缓存中所有数据组装成一个报文段发送出去。当发送缓存中数据达到对方接收窗口一半或者达到MSS时立刻发送。
5.3、糊涂窗口综合症
当接收方缓冲区已满会向发送方发送一个rwnd为0的报文告诉对方不要再发了。当应用进程读取1字节接收缓存时,接收方向发送方发送rwnd = 1的报文此时发送方将1字节的数据打包成报文段发送给接收方。如此循环往复每次只能发一个字节。
解决方案:
接收方等待一段时间,使得接收缓存已有足够空间容纳一个最长的报文段,或者等到接收缓存已有一半空间;只要出现这两种情况之一,接收方就发出确认报文,并向发送方通知当前窗口的大小。
6、拥塞控制
6.1、拥塞控制概述
拥塞:当对网络资源的需求超过了现有的资源的可用部分。
拥塞出现的原因:
- 链路容量不够大,在链路上形成堆积,路由器一直是高负荷运转。
- 路由器缓存不够大,交来的数据太多远远超过了处理的速度就会在路由器缓存形成堆积,堆不下的就丢失了。
- 处理机太慢了。
网络拥塞往往是多种原因的,仅仅增加网络资源有可能适得其反。比如说增大路由器的缓存但并未增加链路带宽和处理机速度会导致排队时间更长一旦用TCP报文传输那么大量的超时重传会引发更严重的问题。提高处理机的速度也不行因为你会把巨大的压力施加给下一跳。需要耗费大量的资源。
6.2、拥塞控制与流量控制
- 流量控制是点到点的,拥塞控制是全局性网络的。
- 拥塞控制是防止过多数据注入到网络,控制发送速率这又与流量控制有些相似。
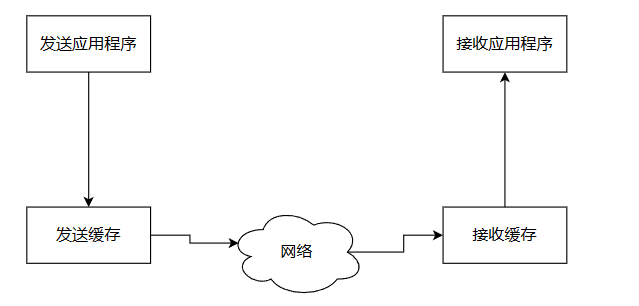
- 流量控制是发送缓存与接收缓存的问题,拥塞控制是网络的问题。
6.3、拥塞控制的原理
- 开环控制方法:在设计网络时考虑发生拥塞的因素,力求网络不发生拥塞。
- 闭环控制方法:
基于反馈环路的概念:
- 检测网络系统以便检测到拥塞在何时何地发生;
- 将拥塞发生的信息传送到可采取行动的地方;
- 调整网络系统的运行已解决出现的问题。
6.4、拥塞出现的指标
- 由于缓冲区不够而造成的分组丢失的百分数。
- 平均队列长度。
- 超时重传的分组数。
- 平均分组时延。
- 平均分组时延标准差。
一旦检测到了拥塞会向源站发送拥塞信息。
6.5、拥塞通知的传递
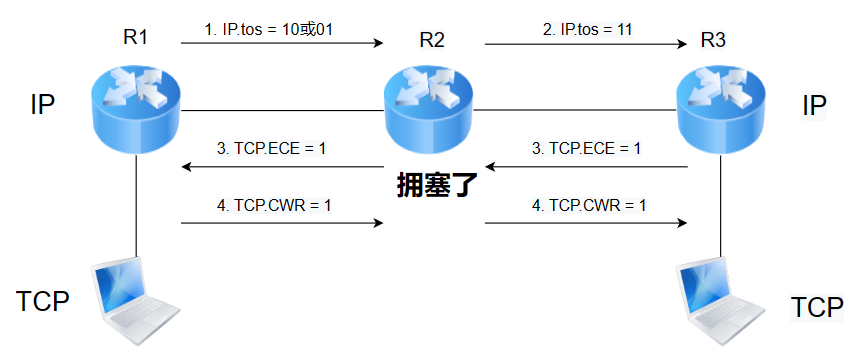
IP中tos字段00表示不支持ECN传输,01或10表示支持ECN传输,11表示产生拥塞。接收端知道产生拥塞后将TCP报文首部中的ECE置为1告诉源端减小发送速率,源端降低速率后下一次发送报文TCP中的CWR置为1降低拥塞窗口(发送窗口是受对方接收窗口和拥塞窗口控制的)。
6.6、TCP拥塞控制方法
TCP采用基于窗口的方法进行拥塞控制,该方法属于闭环控制方法。TCP发送方维持一个拥塞窗口,拥塞窗口根据网络的拥塞程度动态的变化。发送端利用拥塞窗口根据拥塞情况调整发送的数据量若网络没有拥塞则增大窗口让他多发数据提高网络利用率。所以真正发送窗口的值为接收窗口值和拥塞窗口值的最小值。
现在我们假设对方接收缓存无限大仅考虑网络问题探讨一下TCP的拥塞控制算法。
6.6.1、慢开始算法
目的:用来探测网络的负载或者承受能力。
算法思路:由小到大逐渐增大拥塞窗口,当自己主机刚连进网络时如果一下注入太多资源可能造成网络拥塞,因此循序渐进的探测网络的拥塞程度。每收到一个确认报文拥塞窗口就增加一个报文段。
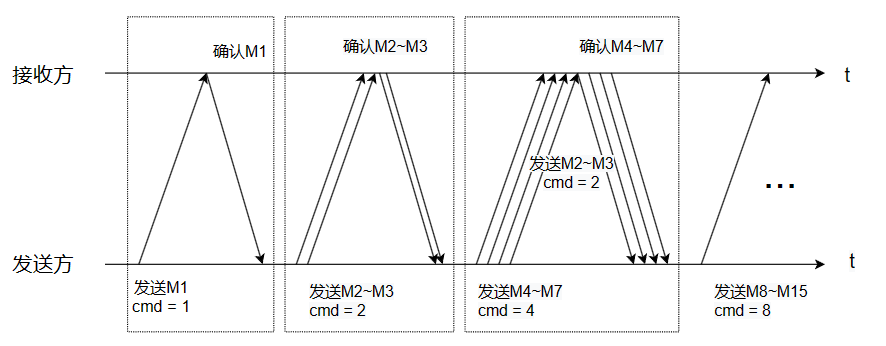
发送方每接收到一个确认报文就将拥塞窗口增加一个报文段。如图所示我们可以看出发送一个收到一个确认下次发两个,收到两个确认下次发2+2=4个收到4个确认下次发4+4等于8个由此可见慢开始算法并不慢。
慢开始门限ssthresh(状态变量)防止拥塞窗口cwnd增长过大引起网络拥塞。
- 当cwnd<ssthresh,使用慢开始算法。
- 当cwnd>sshresh,停止使用慢开始算法而使用拥塞避免方法。
- 当cwnd = sshresh时既可以使用慢开始算法也可以使用拥塞避免算法。
拥塞避免算法:每经过一个RTT,cwnd = cwnd + 1,他的增长是线性的。
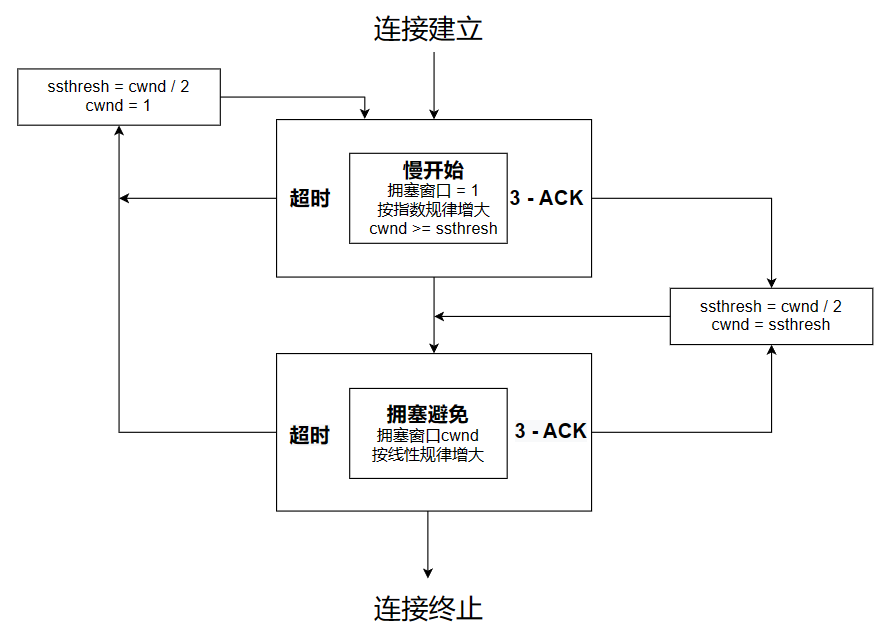
当出现网络拥塞时,ssthresh = max(cwnd/2,2);cwnd = 1;执行慢开始算法。
目的:迅速减少网络中的分组数,有利于路由器将积压的分组处理完。
6.6.2、拥塞控制流程
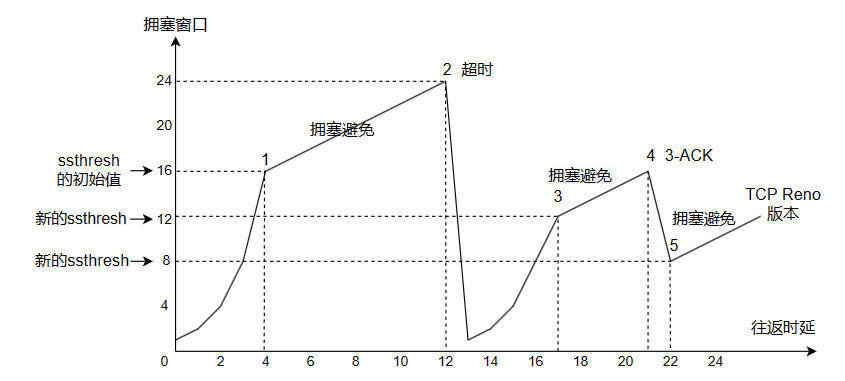
- 0~1执行慢开始算法拥塞窗口呈指数级增大。
- 1~2达到慢开始门限时执行拥塞避免算法拥塞窗口呈线性增大。
- 2~3超时重传可能出现网络拥塞执行将拥塞窗口置1重新执行慢开始算法。
- 34同12
- 4~5中间出现报文丢失收到3个确认报文执行快重传
6.6.3、快重传
快重传算法要求接收方不要等待自己发送数据时才进行捎带确认,而是要立即发送确认,即使收到了失序的报文也要立即发出对已收到的报文段的重复确认。发送方只需要一连收到3个重复确认就立即重传这样就不会出现超时。
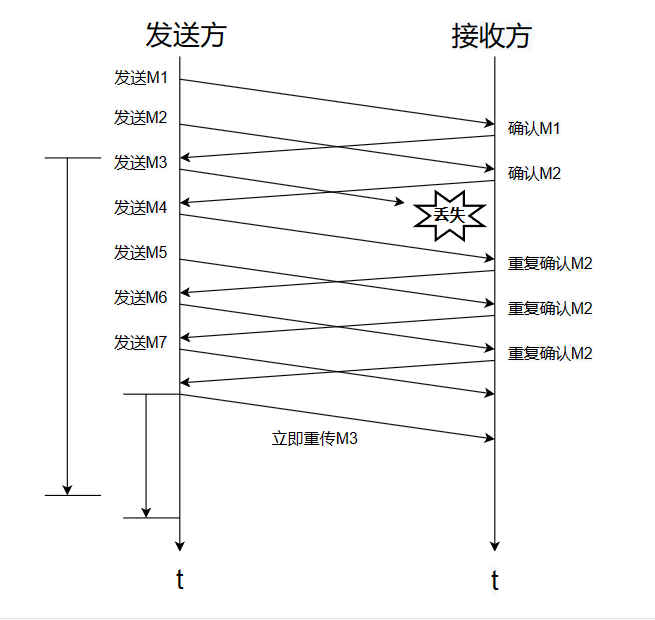
当我发送M3时发生了报文丢失按理说我应该等超时之后再重新发送。但是这样做有可能导致误会这时候网络可能没有发生拥塞。当M3丢失后接收方发送已接收报文的重复确认即M2当M2重复确认3次M3立即重传。快重传算法可以让发送方尽早知道报文发生了丢失。这样就不会超时,就不会让对方误以为发生了拥塞。
6.6.4、快恢复算法
- 当发送端收到连续3个重复确认时,发送方认为网络很可能没有发生阻塞,因此不执行慢开始算法,而是执行快恢复算法;
- ssthresh = cwnd/2;
- 新拥塞窗口cwnd = ssthresh;
- 开始执行拥塞避免算法,使拥塞窗口缓慢地线性增大。
7、TCP的连接与断开
7.1、TCP的连接建立
7.1.1、TCP连接建立过程中要解决的3个问题
- 要使一方确定对方的存在。
- 双方之间协商一些参数比如说滑动窗口的大小,时间戳选项等等。
- 能够对运输实体资源(缓存大小,连接表中的项目)进行一些分配。
7.1.2、三次握手建立连接
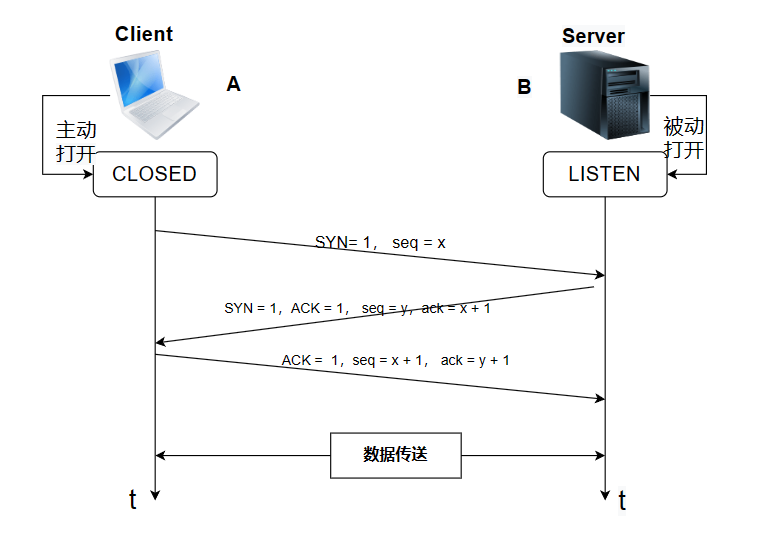
在建立连接之前,Client处于CLOSED状态,而Server处于LISTEN的状态。
- 第一次握手:客户端主动给服务端发送一个SYN报文,并携带自己的初始化序列号一起发送给服务端。此时客户端处于一个SYN_SEND的状态。
- 第二次握手:服务端收到客户端发来的SYN报文之后,就会以自己的SYN报文作为应答,然后将自己的初始化序列号发送给客户端,并且会将客户端的初始化序列号+1作为自己的ACK值发送给客户端,以表示自己已经收到了客户端的SYN报文。此时服务端处于一个SYN_RECV的状态。
- 第三次握手:客户端收到服务端发来的SYN报文之后,会把服务端的初始化序列号+1作为ACK值发送给服务端,用来表示自己已经收到了服务端发来的SYN报文。此时客户端处于一个ESTABLISHED的状态。
7.1.3、为什么两次不行
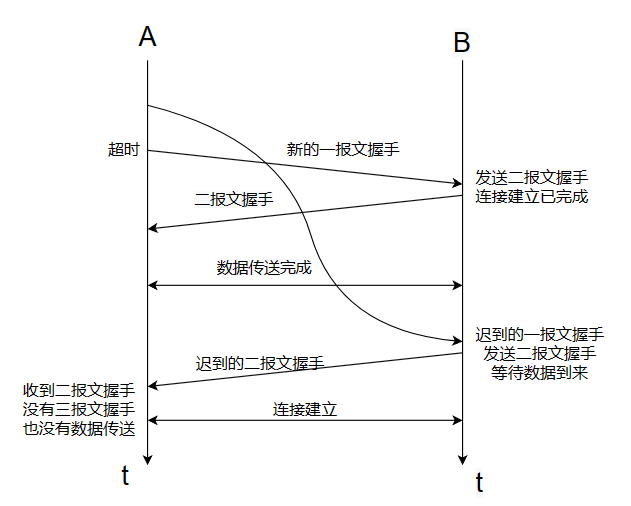
一开始A向B发出建立连接的请求但是这个报文超时了,A又向B发送了一个请求连接报文然后通过两次握手建立连接传送数据最后释放连接。但是这时候,超时的报文迟到发送他们又会建立连接然后服务端等待发送数据,但是这时候客户端已经没有数据可发了。
7.1.4、三次握手的原因
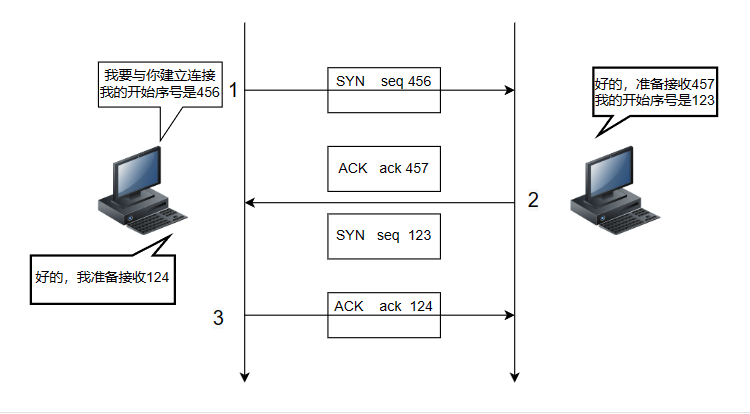
可靠性要求之一(确认、序号、重传):起始数据字节编号协商
如图所示它主要是为了起始数据字节编号协商1是我发送的报文序号是456,2是我接受到了你下次从457开始发,3是好的我准备接收124。如果没有这个3号报文B端就不知道下次从哪开始发。
7.1.5、三次握手建立TCP连接的各种状态
首先服务端开始处于监听状态监听客户端发来的请求,客户端发送建立连接的请求之后处于SYN-SEND状态,服务端发送确认报文之后处于SYN-RCVD状态,当客户端发送确认报文给服务端客户端处于ESTAB-LISHED(连接建立状态)服务端接收到报文后进入ESTAB-LISHED状态。
7.1.6、三次握手可以携带数据吗?
大概很多人的正常思维都是在三次握手过程中是不可以携带数据的,其实不然,在第三次握手的过程中是可以携带数据滴;换句话说就是,在第一、第二次握手过程中不可以携带数据的,但是在第三次握手过程中是可以携带数据的。
那为什么会这样呢?大家不妨大胆的猜测猜测....
因为是网络连接,就会涉及到网络安全的因素;大家想想,如果在第一次握手的时候就可以携带数据,那么要是有人蓄谋已久恶意攻击服务器,在第一次握手中的SYN报文注入大量数据,攻击者根本就不考虑服务器的发送接收能力,然后就疯狂重复发SYN报文,这就会让服务器花费大量的内存和时间去处理这些报文,所以如果在第一次握手就放数据的话,就会让服务器更加容易受到攻击。
7.2、TCP连接释放
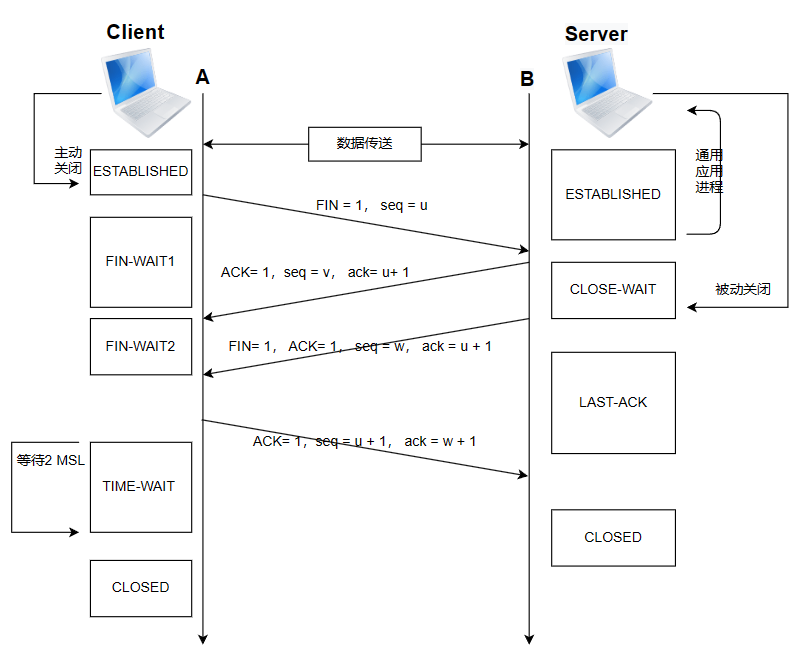
- 第一次挥手(FIN-1):
- 客户端发送一个 FIN 报文段给服务器,表示客户端已经没有数据要发送了,请求关闭连接。
- 客户端进入 FIN_WAIT_1 状态,等待服务器的确认。
- 第二次挥手(ACK):
- 服务器收到客户端的 FIN 报文段后,发送一个 ACK 报文段作为应答,表示已经接收到了客户端的关闭请求。
- 服务器进入 CLOSE_WAIT 状态,等待自己的数据发送完毕。
- 第三次挥手(FIN-2):
- 服务器发送一个 FIN 报文段给客户端,表示服务器也没有数据要发送了,请求关闭连接。
- 服务器进入 LAST_ACK 状态,等待客户端的确认。
- 第四次挥手(ACK):
- 客户端收到服务器的 FIN 报文段后,发送一个 ACK 报文段作为应答,表示已经接收到了服务器的关闭请求。
- 客户端进入 TIME_WAIT 状态,等待可能出现的延迟数据。
- 服务器收到客户端的 ACK 报文段后,完成关闭,进入 CLOSED 状态。
- 客户端在 TIME_WAIT 状态结束后,关闭连接,进入 CLOSED 状态。
7.2.1、为什么客户端要等2MSL才关闭
- 因为服务端要保证TCP全双工通信连接都能正确关闭,因为如果服务端没收到ACK那么就会再发一次FIN那么客户端如果关闭则无法回复ACKServer就会收到RST而不是ACK。所以为了让服务端能正确的收到ACK报文确保连接正确关闭所以要等一会再关。
- 一旦客户端直接进入CLOSED很有可能端口号跟之前相同然后上一次连接中有些数据滞留在网络,当你再建立连接时这些老的数据包会和新的数据混淆等待2MSL基本上可以让这些老数据消失。
7.2.2、保活计时器
- 当建立连接之后一旦断网了,连接空闲时间达到两个小时以上服务器自动发送探测报文段,若发送了10个报文段(每个相隔75秒)还没有响应,就假定客户除了故障,因而终止连接。
- TCP计时器总结:TCP发送报文计时器,超时重传计时器,保活计时器,持续(0窗口探测计时器),时间等待计时器(2MSL);
7.3、TCP黏包
7.3.1、什么是TCP黏包?
在以往的网络基础学习中,客户端可能会连续不断向服务端发送数据包的时候,服务端接收的数据会出现两个数据包黏在一起的情况。
- TCP是基于字节流的可靠传输,在应用层和传输层之间的数据交互是大小不等的数据块,但是TCP就会将这些数据块看成是一串一串没有结构的字节流,并且没有边界。
- 学习TCP结构的时候也可以看出,它的首部没有表示数据长度的字段。
所以,在使用TCP进行数据传输的时候,就会有黏包或者拆包的现象发生。一个数据包中包含了发送端发送的两个数据包的信息,那么就把这种现象叫做黏包。接收端在收到这两个数据包的时候,要么是不完整的,要么是多出来一块,这种情况就是发生了黏包和拆包。
7.3.2、TCP黏包是怎么产生的?
- 发送方产生黏包
因为在采用TCP传输数据的客户端和服务端是保持一个长链接的状态,双方在不断开的状态下,是可以一直传输数据的。如果发送的数据包非常小的时候,那么TCP默认就会启用Nagle算法,将这些非常小的数据包进行合并发送(这个合并发送过程就是在发送缓冲区中进行的),发出来的数据就会是一个黏包的状态。
- 接收方产生黏包
数据在到达接收方的时候,是从网络模型的下方传递至传输层,传输层的TCP协议就会将这些数据放置到接收缓冲区,然后由应用层主动获取,那么这个时候就会出现在我们程序调用的读取数据函数不能及时的把缓冲区中的数据拿出来,下一个数据的一部分就又到缓冲区中,当我们读取的时候就是黏包。
7.3.3、怎么解决黏包和拆包?
- FixedLengthFrameDecoder
对于使用固定长度的粘包和拆包场景,可以使用FixedLengthFrameDecoder,该解码器会每次读取固定长度的消息,如果当前读取到的消息不足指定长度,那么就会等待下一个消息到达后进行补足。
- LineBasedFrameDecoder与DelimiterBasedFrameDecoder
对于通过分隔符进行粘包和拆包问题的处理,Netty提供了两个编解码的类,LineBasedFrameDecoder和DelimiterBasedFrameDecoder。这里LineBasedFrameDecoder的作用主要是通过换行符,即\n或者\r\n对数据进行处理;而DelimiterBasedFrameDecoder的作用则是通过用户指定的分隔符对数据进行粘包和拆包处理。
- LengthFieldBasedFrameDecoder与LengthFieldPrepender
这里LengthFieldBasedFrameDecoder与LengthFieldPrepender需要配合起来使用,其实本质上来讲,这两者一个是解码,一个是编码的关系。它们处理粘拆包的主要思想是在生成的数据包中添加一个长度字段,用于记录当前数据包的长度。
- 自定义粘包与拆包器
对于粘包与拆包问题,其实前面三种基本上已经能够满足大多数情形了,但是对于一些更加复杂的协议,可能有一些定制化的需求。对于这些场景,其实本质上,我们也不需要手动从头开始写一份粘包与拆包处理器,而是通过继承LengthFieldBasedFrameDecoder和LengthFieldPrepender来实现粘包和拆包的处理。
8、UDP主要特点
- 不需要建立连接。
- 尽最大努力交付。
- 面向报文交付。
- 没有拥塞控制。
- 支持多种交互通信。
- 首部开销小仅有8字节。
- 应用程序必须选择合适的报文如果报文太长则需要IP分片,太小降低效率。
8.1、运用场景:
- 可以重复请求信息的情况下例如:RIP,DNS,DHCP等
- 一次性传小量数据的应用
- 实时应用
- 多媒体应用。
8.2、UDP首部信息
- 源端口(2)
- 目的端口(2)
- 长度(2)
- 检验和(2)(首部+伪首部+数据)
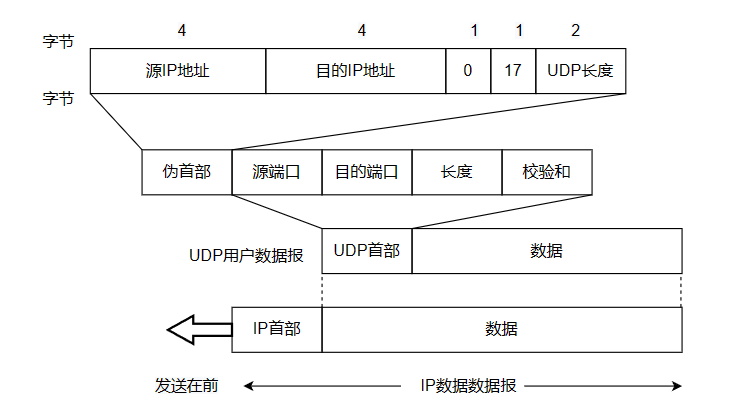
这个检验和是交给上层应用程序检查的,它就相当于你拆快递先检查收货地址(IP地址),再检查是不是你的名字(端口),再检查里面收件是不是错的(里面的数据)。