
腾讯音乐后端实习面试原题:手撕LRU和接雨水,网友:面完秒挂。。
来源:https://www.nowcoder.com/feed/main/detail/31428f36ffcf4cc499546ec16221e2d4
1、手写LRU
使用哈希表和双向链表来实现。
import java.util.HashMap;
import java.util.Map;

class LRUCache {
    class Node {
        int key;
        int value;
        Node prev;
        Node next;

        public Node(int key, int value) {
            this.key = key;
            this.value = value;
        }
    }

    private int capacity; // 缓存容量
    private Map<Integer, Node> map; // 存储缓存键值对的哈希表
    private Node head; // 链表头部,表示最近使用的节点
    private Node tail; // 链表尾部,表示最近最少使用的节点

    public LRUCache(int capacity) {
        this.capacity = capacity;
        this.map = new HashMap<>();
        this.head = new Node(0, 0); // 创建头部节点
        this.tail = new Node(0, 0); // 创建尾部节点
        this.head.next = this.tail; // 头部节点指向尾部节点
        this.tail.prev = this.head; // 尾部节点指向头部节点
    }

    public int get(int key) {
        if (!map.containsKey(key)) {
            return -1; // 如果键不存在,返回 -1
        }
        Node node = map.get(key);
        removeNode(node); // 将节点移除当前位置
        addToHead(node); // 将节点移动到链表头部,表示最近使用
        return node.value;
    }

    public void put(int key, int value) {
        if (map.containsKey(key)) {
            Node node = map.get(key);
            node.value = value; // 更新节点值
            removeNode(node); // 将节点移除当前位置
            addToHead(node); // 将节点移动到链表头部,表示最近使用
        } else {
            if (map.size() >= capacity) {
                Node tailPrev = tail.prev; // 获取尾部节点的前一个节点
                removeNode(tailPrev); // 将尾部节点的前一个节点移除,即最近最少使用的节点
                map.remove(tailPrev.key); // 从哈希表中移除对应的键值对
            }
            Node newNode = new Node(key, value); // 创建新节点
            map.put(key, newNode); // 将新节点加入哈希表
            addToHead(newNode); // 将新节点移动到链表头部,表示最近使用
        }
    }

    private void removeNode(Node node) {
        node.prev.next = node.next; // 将节点的前驱指向节点的后继
        node.next.prev = node.prev; // 将节点的后继指向节点的前驱
    }

    private void addToHead(Node node) {
        node.next = head.next; // 将节点的后继指向原头部节点的后继
        node.prev = head; // 将节点的前驱指向头部节点
        head.next.prev = node; // 将原头部节点的后继节点的前驱指向新节点
        head.next = node; // 将头部节点的后继指向新节点
    }
}

public class Main {
    public static void main(String[] args) {
        LRUCache cache = new LRUCache(2);
        cache.put(1, 1);
        cache.put(2, 2);
        System.out.println(cache.get(1)); // 输出 1
        cache.put(3, 3);
        System.out.println(cache.get(2)); // 输出 -1,因为缓存容量已满,2 被淘汰
        cache.put(4, 4);
        System.out.println(cache.get(1)); // 输出 -1,因为键 1 已被淘汰
        System.out.println(cache.get(3)); // 输出 3
        System.out.println(cache.get(4)); // 输出 4
    }
}
2、项目拷打
3、HTTPS客户端校验证书的细节?
证书链验证:
- 客户端会从服务器返回的证书中提取出证书链(Certificate Chain),并逐级验证证书链的有效性。
- 验证过程中,客户端会检查每个证书的签发者是否是上一级证书的主题,并且验证每个证书的有效期是否在当前时间范围内。
- 客户端会检查证书链的最后一级是否是受信任的根证书颁发机构(Root CA)。如果根证书不在客户端的信任列表中,或者证书链中的任何一级证书无效,校验将失败,连接将被终止。
主机名验证:
- 客户端会检查服务器证书中的主机名信息是否与当前访问的主机名匹配。这是为了防止中间人攻击(Man-in-the-Middle Attack)。
- 如果服务器证书中包含了 Subject Alternative Name (SAN) 字段,则客户端会从中获取主机名信息进行匹配。
- 如果服务器证书中没有 SAN 字段,则客户端会使用 Common Name (CN) 字段中的主机名进行匹配。
证书吊销检查:
- 客户端可以通过在线查询证书吊销列表(Certificate Revocation List,CRL)或者使用 OCSP(Online Certificate Status Protocol)来检查服务器证书是否被吊销。
- 如果证书被吊销或者无法验证证书的有效性,连接将被终止。
TLS 版本和加密算法验证:
客户端会根据服务器支持的 TLS 版本和加密算法选择合适的协议进行通信。通常会选择支持的最高版本的 TLS,并且要求使用安全的加密算法,如AES等。
安全传输:
一旦证书验证通过,客户端与服务器之间的通信将使用 TLS 协议进行加密传输,确保数据的安全性和完整性。
4、对称加密和非对称加密的区别?你分别了解哪些算法?
区别
- 密钥类型:
- 对称加密:使用相同的密钥进行加密和解密,这个密钥需要在通信双方之间提前共享,并且需要保密。
- 非对称加密:使用一对密钥,分别是公钥和私钥。公钥可以公开给任何人使用,而私钥则需要保密。公钥用于加密数据,私钥用于解密数据。
- 加密速度:
- 对称加密:通常加密和解密速度较快,适合大量数据的加密和解密。
- 非对称加密:由于非对称加密算法的复杂性,加密和解密速度较慢,适合用于少量数据或者密钥交换。
- 安全性:
- 对称加密:密钥的安全性对整个加密系统的安全至关重要。如果密钥泄露,整个系统就会被破解。
- 非对称加密:由于公钥可以公开,因此不需要像对称加密那样频繁地传递密钥。但是,非对称加密的安全性也取决于私钥的安全性。
常见的加密算法
- 对称加密算法:
- DES(Data Encryption Standard):是一种对称密钥加密算法,使用 56 位的密钥,对数据进行加密和解密。由于密钥长度较短,已经不推荐使用。
- 3DES(Triple DES):是对 DES 的改进,使用三个 56 位的密钥进行加密,提高了安全性。但由于密钥长度仍然较短,安全性不足以应对当前的攻击方式。
- AES(Advanced Encryption Standard):是目前最常用的对称加密算法之一。它支持多种密钥长度(128 位、192 位、256 位),安全性较高,速度快,适用于各种场景。
- 非对称加密算法:
- RSA:是最早的非对称加密算法之一,使用一对公钥和私钥进行加密和解密。RSA 安全性较高,常用于数字签名和密钥交换。
- DSA(Digital Signature Algorithm):用于数字签名,基于离散对数问题。常用于数字签名算法。
- ECC(Elliptic Curve Cryptography):基于椭圆曲线离散对数问题,与 RSA 相比,它在相同安全级别下所需的密钥长度更短,因此更适合在资源受限的环境中使用。
5、在信息传输过程中,Https用的是对称加密还是非对称加密?
HTTPS 在信息传输过程中同时使用了对称加密和非对称加密,结合了两者的优势。
- 握手阶段:
- 客户端向服务器发送一个随机数和支持的加密算法列表。
- 服务器从中选择一个加密算法,并向客户端发送一个包含服务器证书、服务器公钥以及一个随机数的消息。
- 客户端接收到服务器的证书后,会验证证书的合法性,并使用服务器的公钥加密一个新的随机数,发送给服务器。
- 密钥交换阶段:
- 服务器收到客户端发送的加密后的随机数后,使用自己的私钥进行解密,得到客户端发送的随机数。然后,服务器和客户端都拥有了两个随机数,分别是客户端生成的和服务器生成的。
- 服务器和客户端使用这两个随机数以及之前协商的加密算法,生成对称加密所需的密钥。
- 加密通信阶段:
- 服务器和客户端使用协商好的对称加密算法和密钥,对通信数据进行加密和解密。对称加密算法的加解密速度快,适合大量数据的加解密操作。
通过这种方式,HTTPS 在握手阶段使用了非对称加密来保证密钥交换的安全性和密钥的保密性,然后在加密通信阶段使用对称加密算法来保证通信数据的加解密速度和效率。这种结合了对称加密和非对称加密的方式,既保证了安全性,又保证了性能。
6、怎么防止下载的文件被劫持和篡改?
- 使用 HTTPS 协议:通过 HTTPS 加密传输文件可以防止中间人攻击和数据篡改。HTTPS 使用 SSL/TLS 协议对通信数据进行加密,确保数据传输的安全性和完整性。
- 数字签名:对文件进行数字签名可以验证文件的真实性和完整性。数字签名使用私钥对文件进行加密,然后使用公钥进行解密验证。如果文件在传输过程中被篡改,数字签名验证会失败。
- 哈希校验:对下载的文件进行哈希计算(如 MD5、SHA-1、SHA-256 等),并与预先公布的哈希值进行比对。如果哈希值匹配,则文件未被篡改。
- 下载源可信度验证:确保从可信的下载源下载文件,避免从未知或不可信的来源下载文件。下载源可以是官方网站、知名的软件仓库或应用商店等。
- 安全下载工具:使用经过验证的安全下载工具来下载文件,这些工具通常提供文件的完整性检查和安全验证功能。
7、Hashmap的put流程?
HashMap 的 put 方法用于向 HashMap 中添加键值对。
流程大致如下:
- 计算键的哈希值:首先,根据键的
hashCode()方法计算键的哈希值。HashMap 使用哈希值来确定键值对在内部数组中的存储位置。 - 计算数组下标:将哈希值通过哈希函数映射到数组的索引位置。通常使用哈希值的低几位作为数组索引。
- 处理冲突:如果多个键具有相同的哈希值,即发生哈希冲突,HashMap 会使用链表或红黑树(JDK 8+)来解决冲突。在 JDK 8 之前,采用链表来存储冲突的键值对;在 JDK 8 及以后,当链表长度超过一定阈值(默认为 8),链表会转换为红黑树,以提高查找效率。
- 插入或更新节点:如果当前位置为空(即没有发生冲突),直接将键值对插入到该位置;如果当前位置已经存在节点(可能是链表的头节点或红黑树的根节点),则根据键是否相等进行更新或插入操作。
- 容量检查和扩容:在插入键值对后,会检查当前元素个数是否超过了负载因子乘以数组大小(默认负载因子为 0.75)。如果超过了负载因子,HashMap 会进行扩容操作,重新计算每个键的哈希值,并重新分配到新的数组中。
8、Volatile 和synchronized的区别?
- 作用范围:
volatile:用于修饰变量,保证变量的可见性和禁止指令重排序。synchronized:用于修饰方法或代码块,实现对代码块或方法的同步访问。
- 内存语义:
volatile:保证被修饰变量的可见性和有序性,当一个线程修改了volatile变量的值,其他线程能立即看到最新的值,且不会重排序。synchronized:通过加锁和释放锁来实现线程间的互斥访问,保证了临界区代码的原子性,也会保证可见性和有序性。
- 使用场景:
volatile:适用于变量的写操作不依赖于变量的当前值,或者仅有一个线程修改变量的情况。常用于标识状态变量或者控制变量。synchronized:适用于需要保证临界区代码的原子性和互斥访问的情况,比如对共享资源的读写操作。
- 性能:
volatile:由于不涉及锁的获取和释放,性能相对较高,适合于变量的写操作频繁,但读操作较少的情况。synchronized:涉及锁的获取和释放,性能相对较低,适合于对共享资源的读写操作都比较频繁的情况。
9、乐观锁如何实现,有哪些缺点?
- 版本号机制:
- 实现原理:每个数据项都有一个版本号字段,用于记录数据的版本信息。当数据被读取时,会将版本号一并读取,并保存在客户端;当数据被更新时,会比较客户端保存的版本号和当前数据的版本号。如果一致,则执行更新操作,并将版本号加一;如果不一致,则表示数据已经被其他线程修改,需要进行冲突处理。
- 缺点:
- 内存开销:每个数据项都需要额外的版本号字段来记录版本信息,可能会增加内存开销。
- 数据一致性:在高并发环境下,可能会导致大量的版本号变更,增加了数据项的冗余信息,可能会影响性能。
- 冲突处理:版本号机制无法避免数据冲突的发生,需要进行冲突处理,通常是通过重试机制来解决。
- CAS算法:
- 实现原理:CAS(Compare And Swap)是一种原子操作,通过原子性地比较内存中的值和预期值,如果相等则进行交换操作,否则不做任何操作。CAS 操作通常用于解决多线程并发访问共享数据时的同步问题。
- 缺点:
- ABA问题:CAS 操作只能判断值是否相等,无法判断值是否被修改过。例如,线程 A 读取数据值为 A,线程 B 将数据值修改为 B,然后再修改回 A,此时线程 A 使用 CAS 操作检查时发现值仍然为 A,无法发现数据已经被修改过。解决方法是使用版本号或者引入额外的标记来解决。
- 循环开销:CAS 操作需要使用循环来不断重试,直到操作成功或达到重试次数的上限。如果并发冲突较多,会导致循环开销较大,影响性能。
10、Springboot的工作机制?
Spring Boot 是一个用于快速构建基于 Spring 框架的应用程序的工具。它简化了 Spring 应用程序的开发过程,提供了自动化配置、快速启动、约定大于配置等特性,使得开发者可以更专注于业务逻辑的实现,而不必过多关注配置细节。
- 自动化配置:Spring Boot 提供了大量的自动化配置,通过在类路径下的特定位置放置配置文件或者使用特定的注解,Spring Boot 将自动配置应用程序所需的各种组件,如数据源、事务管理器、Web 容器等。
- 启动器:Spring Boot 提供了一系列的启动器(Starter),它们是一组预定义的依赖项集合,可以方便地引入常用的框架和库,如 Spring MVC、JPA、Thymeleaf 等。启动器将相关依赖项整合在一起,简化了项目的依赖管理。
- 嵌入式 Web 服务器:Spring Boot 默认集成了嵌入式的 Web 服务器,如 Tomcat、Jetty 或 Undertow,开发者无需手动配置,即可快速启动一个独立的 Web 应用程序。
- 约定大于配置:Spring Boot 遵循约定大于配置的原则,通过约定来简化配置。例如,约定了特定的目录结构和命名规范,使得 Spring Boot 能够自动扫描并注册组件,无需手动配置。
- 外部化配置:Spring Boot 支持将配置信息外部化,可以通过属性文件、环境变量、命令行参数等方式进行配置,使得应用程序的配置更加灵活和易于管理。
- 运行时热部署:Spring Boot 支持运行时热部署,开发者可以在修改代码后立即生效,无需重启应用程序,提高了开发效率。
11、缓存雪崩解决方案?
缓存雪崩指的是缓存中的多个键同时失效或被清除,导致大量的请求同时涌入数据库或其他后端存储系统,造成数据库负载激增。缓存雪崩通常发生在以下情况下:
- 大量的缓存数据具有相同的过期时间,当这些数据同时过期时,会导致请求同时触发对后端存储的查询。
- 缓存服务器发生故障或重启,导致所有缓存数据被清除,然后需要重新加载。
解决方法:
- 设置不同的过期时间: 避免将所有缓存数据设置为相同的过期时间。可以采用随机化或分层的方式,使缓存数据的过期时间不完全一致,减少了同时失效的概率。
- 使用热点数据预加载: 对于关键的热点数据,可以在缓存数据即将过期时提前异步加载,以确保数据不会同时失效。
- 备份缓存服务器: 使用多个缓存服务器,并设置主备关系。当主缓存服务器故障时,备份服务器可以继续提供服务,避免缓存全部失效。
- 限流和降级: 实施请求限流和服务降级策略,以减少后端系统的压力。当缓存失效时,可以暂时限制请求的数量或降低某些请求的优先级。
12、多级缓存如何保证数据一致性?
- 缓存更新策略:当数据发生变化时,需要及时更新所有级别的缓存。可以采用以下策略之一:
- 直接更新:在更新数据库后,直接更新内存缓存和分布式缓存中的数据。
- 延迟更新:在更新数据库后,先更新内存缓存,然后由内存缓存异步地更新分布式缓存。这样可以降低分布式缓存的更新频率,减少数据库的压力。
- 定时更新:定期检查数据库中的数据变化,然后更新内存缓存和分布式缓存。这种方式可以减少实时更新带来的性能开销,但可能会造成数据的不一致性。
- 缓存失效策略:为了避免数据在缓存中过期而导致的不一致性,可以设置合理的缓存失效时间,保证数据在缓存中的有效性。可以采用以下策略之一:
- 定时刷新:定期刷新缓存中的数据,保证数据在缓存中的有效性。
- 根据数据特性设置失效时间:根据数据的特性和访问频率,设置合理的失效时间,避免数据在缓存中过期。
- 缓存雪崩预防:为了避免由于某一级缓存的失效导致大量请求直接打到下一级缓存或数据库,可以采用以下策略之一:
- 分散失效时间:对于相同类型的数据,在不同级别的缓存中设置不同的失效时间,避免大量数据同时失效。
- 热点数据永不过期:对于热点数据,可以设置永不过期,保证数据始终可用。
- 数据回源策略:当缓存中的数据失效或者不存在时,需要从数据库中回源获取数据。可以采用以下策略之一:
- 先从内存缓存获取:先从内存缓存中获取数据,如果不存在或者失效,则从分布式缓存中获取,再从数据库中获取。
- 先从分布式缓存获取:先从分布式缓存中获取数据,如果不存在或者失效,则从数据库中获取。
13、mysql索引失效的几种情况?
未使用索引字段:当查询条件中的字段未被索引覆盖,或者使用了函数、表达式、类型转换等操作,导致无法命中索引。例如:
sqlSELECT * FROM table WHERE YEAR(date_column) = 2022;上述查询中,对
date_column进行了函数操作,无法命中索引。索引列顺序不合理:当查询条件中的索引列不是组合索引的第一个列,或者组合索引的顺序与查询条件不匹配时,导致索引失效。例如:
sqlCREATE INDEX idx_name_age ON table (name, age); SELECT * FROM table WHERE age = 30 AND name = 'Alice';上述查询中,索引
idx_name_age是(name, age)的组合索引,但查询条件中的顺序与索引不一致,导致索引失效。范围查询:当查询条件中包含范围查询(如
BETWEEN、IN、LIKE等)时,索引可能无法被完全利用。例如:sqlSELECT * FROM table WHERE age BETWEEN 20 AND 30;上述查询中,如果
age字段有索引,但是由于查询条件是一个范围,索引可能无法被完全利用。使用
OR条件:当查询条件中使用了OR连接多个条件时,如果这些条件无法被合并为一个索引范围查询,可能导致索引失效。例如:sqlSELECT * FROM table WHERE age = 20 OR name = 'Alice';上述查询中,如果
age和name字段分别有索引,但是由于使用了OR连接,无法利用索引优化查询。数据分布不均匀:当索引列的数据分布不均匀时,可能导致索引失效。例如,某些值的出现频率过高或过低,使得索引无法有效过滤数据。
14、手撕:接雨水。
问题描述
给定 n 个非负整数表示每个宽度为 1 的柱子的高度图,计算按此排列的柱子,下雨之后能接多少雨水。
示例 1:
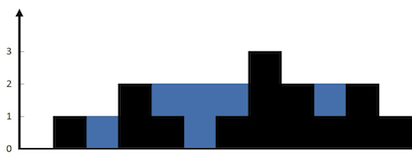
输入:height = [0,1,0,2,1,0,1,3,2,1,2,1]
输出:6
解释:上面是由数组 [0,1,0,2,1,0,1,3,2,1,2,1] 表示的高度图,在这种情况下,可以接 6 个单位的雨水(蓝色部分表示雨水)。
示例 2:
输入:height = [4,2,0,3,2,5]
输出:9
提示:
n == height.length1 <= n <= 2 * 1040 <= height[i] <= 105
思路
- 计算每个柱子能接的雨水:对于每个柱子,能接的雨水取决于其左边最高柱子的高度和右边最高柱子的高度中较小的一个。设定两个数组
leftMax和rightMax分别记录每个柱子左边和右边的最高柱子高度。 - 遍历计算雨水:从左到右遍历每个柱子,计算当前柱子能接的雨水量。具体步骤如下:
- 计算
leftMax数组:从左到右遍历一次,记录每个位置左边的最高柱子高度。 - 计算
rightMax数组:从右到左遍历一次,记录每个位置右边的最高柱子高度。 - 遍历每个柱子:对于每个位置
i,计算当前柱子的高度height[i]与leftMax[i]和rightMax[i]中较小值的差值,即为当前柱子能接的雨水量。
- 计算
- 求和得到总雨水量:将每个柱子能接的雨水量累加起来,即为最终的总雨水量。
参考代码
Java
class Solution {
    public int trap(int[] height) {
        int n = height.length;
        if (n == 0) {
            return 0;
        }

        int[] leftMax = new int[n]; // 记录每个位置左边的最高柱子高度
        int[] rightMax = new int[n]; // 记录每个位置右边的最高柱子高度

        // 计算 leftMax 数组
        leftMax[0] = height[0];
        for (int i = 1; i < n; i++) {
            leftMax[i] = Math.max(leftMax[i - 1], height[i]);
        }

        // 计算 rightMax 数组
        rightMax[n - 1] = height[n - 1];
        for (int i = n - 2; i >= 0; i--) {
            rightMax[i] = Math.max(rightMax[i + 1], height[i]);
        }

        // 计算每个位置能接的雨水量并累加
        int water = 0;
        for (int i = 0; i < n; i++) {
            water += Math.min(leftMax[i], rightMax[i]) - height[i];
        }

        return water;
    }

    public static void main(String[] args) {
        Solution solution = new Solution();
        // 示例输入
        int[] height = {0,1,0,2,1,0,1,3,2,1,2,1};
        System.out.println(solution.trap(height)); // 输出 6
    }
}
C++
#include <vector>
#include <algorithm>
#include <iostream>

using namespace std;

class Solution {
public:
    int trap(vector<int>& height) {
        int n = height.size();
        if (n == 0) {
            return 0;
        }

        vector<int> leftMax(n); // 记录每个位置左边的最高柱子高度
        vector<int> rightMax(n); // 记录每个位置右边的最高柱子高度

        // 计算 leftMax 数组
        leftMax[0] = height[0];
        for (int i = 1; i < n; i++) {
            leftMax[i] = max(leftMax[i - 1], height[i]);
        }

        // 计算 rightMax 数组
        rightMax[n - 1] = height[n - 1];
        for (int i = n - 2; i >= 0; i--) {
            rightMax[i] = max(rightMax[i + 1], height[i]);
        }

        // 计算每个位置能接的雨水量并累加
        int water = 0;
        for (int i = 0; i < n; i++) {
            water += min(leftMax[i], rightMax[i]) - height[i];
        }

        return water;
    }
};

int main() {
    Solution solution;
    // 示例输入
    vector<int> height = {0,1,0,2,1,0,1,3,2,1,2,1};
    cout << solution.trap(height) << endl; // 输出 6
    return 0;
}
Python
class Solution:
    def trap(self, height: List[int]) -> int:
        n = len(height)
        if n == 0:
            return 0

        left_max = [0] * n  # 记录每个位置左边的最高柱子高度
        right_max = [0] * n  # 记录每个位置右边的最高柱子高度

        # 计算 left_max 数组
        left_max[0] = height[0]
        for i in range(1, n):
            left_max[i] = max(left_max[i - 1], height[i])

        # 计算 right_max 数组
        right_max[n - 1] = height[n - 1]
        for i in range(n - 2, -1, -1):
            right_max[i] = max(right_max[i + 1], height[i])

        # 计算每个位置能接的雨水量并累加
        water = 0
        for i in range(n):
            water += min(left_max[i], right_max[i]) - height[i]

        return water

# 示例输入
solution = Solution()
height = [0,1,0,2,1,0,1,3,2,1,2,1]
print(solution.trap(height))  # 输出 6